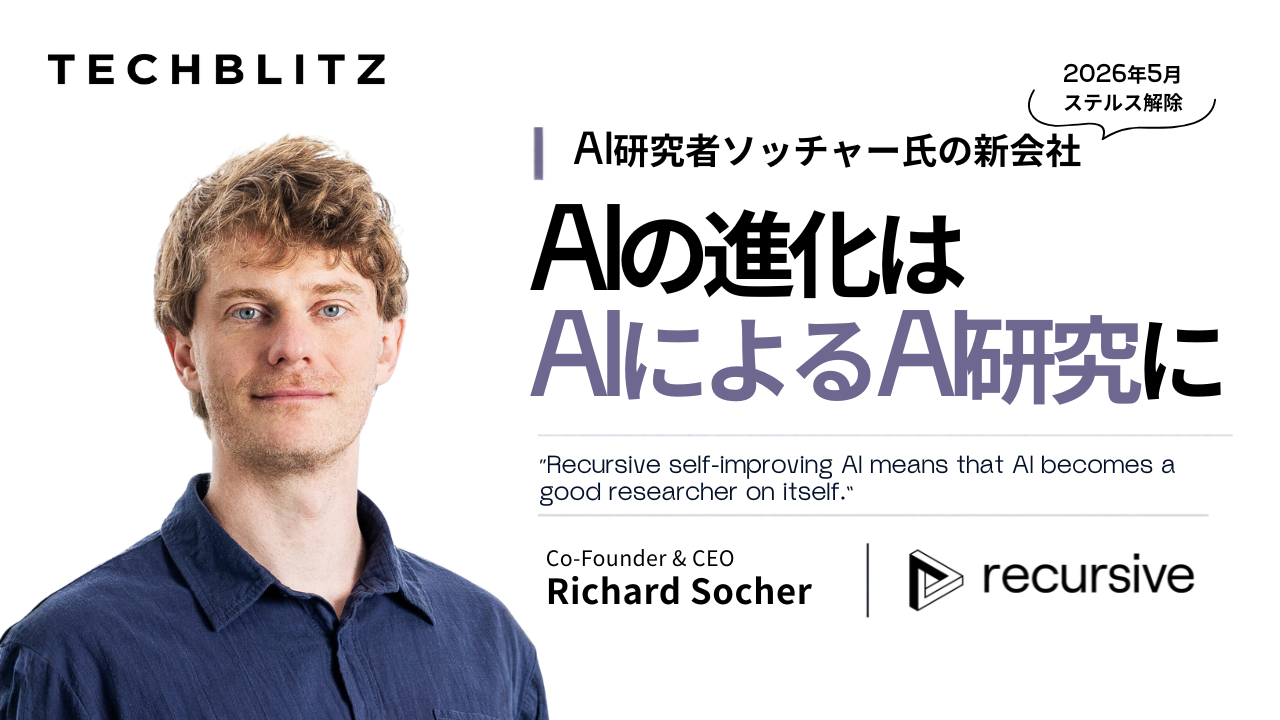
2010年当時、自然言語処理にニューラルネットワークを持ち込むという発想は物議を醸した。いまではそれが当たり前になっている。その流れをつくった研究者の一人がリチャード・ソッチャー(Richard Socher)氏だ。Google Scholarでの被引用数は25万件近くに上り、自然言語処理の分野で3番目に多い。
そのソッチャー氏が次の研究テーマに選んだのが、AIが自分自身を研究し改良する「再帰的自己改善」。拠点は2025年に共同創業し、2026年5月にステルスモードを解除したRecursive Superintelligence(リカーシブ・スーパーインテリジェンス、以下リカーシブ)だ。
ソッチャー氏はかつてSalesforceのチーフサイエンティストとしてAI研究を率い、その後、AI検索を手がけるYou.comを創業した。You.comはChatGPTの登場前からAIとウェブ検索を組み合わせ、現在はAIエージェントなどが最新のウェブ情報を利用するための検索基盤を提供している。
研究成果を企業のサービスへとつなげてきたソッチャー氏は、今度はAIに「研究する役割」そのものを担わせようとしている。前編では、研究者として見たAIの現在地と、再帰的自己改善の考え方を聞いた。
AIは、自分の弱点を見つけて伸ばせるか
ソッチャー氏が語る、従来の学習方法と「再帰的自己改善」が目指す姿
| 比較する点 | これまでのAI | 再帰的自己改善AIが目指す姿 |
|---|---|---|
| 学び方 | 人間がデータセットや評価基準を与え、特定のタスクで能力を高める。 | AIが自らの苦手な領域を見つけ、改善方法を探索する。 |
| 能力の広がり | 難問には強くても、別の簡単な作業はできないことがある。「とがった能力」が残る。 | 能力が足りない「谷間」を埋め、ほかのAIとも協調しながら対応できる領域を広げる。 |
| 成長の壁 | 学習データを増やしても、能力の伸びが鈍くなる場合がある。 | AIによる研究・改良を繰り返し、能力向上を加速させることを目指す。 |
※右列は構想・研究目標を示しており、すべて実現した能力ではありません。
目次
・2010年は異端、今は定説。AI研究者ソッチャーの歩み
・AIの成長はS字カーブの平らな局面に
・AIが「自分自身の研究者」になる。再帰的自己改善とは
・AIの「尖った能力」と「谷間」。進化に学ぶオープンエンド性
・大手も動き出した「AIによるAI研究」
・記事後編は…
2010年は異端、今は定説。AI研究者ソッチャーの歩み
―まずは、研究者としての歩みを教えてください。
スタンフォード大学で博士号を取得し、自然言語処理(NLP)の分野にニューラルネットワークを持ち込みました。2010年当時は非常に物議を醸すアイデアでしたが、今ではごく当たり前の考え方です。現在、Google Scholar上では自然言語処理の分野で3番目に多く引用されている研究者で、被引用数は25万件近くに上ります。
博士号取得後はスタンフォードで教える一方、企業が簡単にニューラルネットワークを学習させられるようにする会社、MetaMindを立ち上げました。同社はSalesforceに買収され、私はチーフサイエンティスト、そして上級副社長(Executive Vice President)として、EinsteinチームをはじめとするAI関連の取り組みの大半を率いました。4年半、すばらしい時間でした。
ソッチャー氏の研究は、AIの歴史のいくつかの転換点に関わっている。2009年には、深層学習ブームの起点となった画像データセット「ImageNet」の論文に共著者として名を連ねた。2013年に発表した、文の感情を構文の木構造に沿って捉える研究(Sentiment Treebank)と、2014年の単語ベクトル「GloVe」は、それぞれ2023年と2024年に、計算言語学会(ACL)のTest-of-Time賞を受けている。発表から10年たっても影響力を持ち続ける論文に贈られる賞だ。2018年には、翻訳や要約といった多様な言語タスクを、すべて「質問に答える」形で一つのモデルに解かせる「decaNLP」を発表した。ソッチャー氏は「私たちがプロンプトエンジニアリングを発明した」と語っている。
2014年に提出した博士論文のタイトルは「Recursive Deep Learning for Natural Language Processing and Computer Vision」。同じニューラルネットワークを文の構造に沿って繰り返し(再帰的に)適用し、人が手で設計した特徴量に頼らずに言葉の意味を学習させる研究で、スタンフォード大学の最優秀博士論文賞(Arthur L. Samuel賞)を受けた。今回の「再帰」は論文のそれとは意味が異なる。それでもソッチャー氏は、10年あまりを経て、再び「Recursive」の名を掲げたことになる。
その後、AI検索インフラのYou.comを創業し、ベンチャーファンドAIX Venturesも運営している(詳しくは後編で紹介)。そして現在の本業が、リカーシブのCEOだ。
AIの成長はS字カーブの平らな局面に
―なぜ今、リカーシブを立ち上げたのでしょうか。
AIの能力は、指数関数的に伸びたあとS字カーブを描いて頭打ちになる、ということを繰り返してきました。そして今、能力の伸びがやや平坦になりつつあります。わずかな能力向上のために、はるかに多くの学習データを与えなければならなくなっているのです。
一方で、私を含むリカーシブの8人の共同創業者には、共通の経験があります。手作業のプロセスを学習によるプロセスに置き換えるたびに、AIの能力は実際に高まる、ということです。
そこで、再帰的に自己改善する超知能を実際に作るために、考えうる最強のチームを集めました。これが今可能になったのは、AIはコードであり、AI自身もコードを書けるからです。ループを閉じれば、生物の進化、文化の進化、技術の進化と同じように、終わりのない探索ができる。AIを進化させられるのです。
──人の手で設計していた部分を、データから学習する仕組みに置き換える。NLPにニューラルネットワークを持ち込んだソッチャー氏の研究も、まさにその実践だった。今回、置き換えの対象になるのは「AIの研究」そのものだ。
AIが「自分自身の研究者」になる。再帰的自己改善とは
―リカーシブは何を作っているのでしょうか。「再帰的に自己改善するAI」とは、具体的にどういう意味ですか。
再帰的に自己改善するAIとは、AIが自分自身についての優れた研究者になる、ということです。AIが自らの弱点をある種「自覚」できるようになり、「この点が苦手だから、この能力を伸ばしたい」とオープンエンドに考え、それを自力で実際にやり遂げる。
真の再帰的自己改善に向けた一歩は、まずAIのほかの部分の研究を自動化することです。それが極めてうまくできるようになれば、やがて自分自身を改良できるようになる。そうなれば、AIの能力の伸びも、異なる企業や用途といった新しい環境への適応も、はるかに急な指数関数を描くようになります。
―現在の開発状況を教えてください。
今は技術を実証することに全力を注いでいます。まさに今夜か明日、AIがすでに何をできるのかを示す最初の発表をする予定です。製品ではなく、あくまでマイルストーンです。パズルのピースはいくつもあり、それらを組み合わせれば本格的な製品を提供できる。今年後半には、エキサイティングな製品もいくつか出てくるはずです。会社を始めてから、まだ数カ月しか経っていませんから。
※この発表は取材翌日の2026年6月11日、研究成果として公開された。その中身は後編で紹介する。
AIの「尖った能力」と「谷間」。進化に学ぶオープンエンド性
―鍵となる考え方の一つが「オープンエンド性(open-endedness)」ですね。
オープンエンド性は、進化に着想を得た考え方です。進化は非常に長く続くプロセスで、続くほどに新しく面白いことが次々と起こります。動物は目や耳や脳を発達させ、やがて文化の進化が起こり、技術の進化が起こる。適切な環境さえあれば、革新を生み出し続けられるプロセスです。
AIには、私が「尖った能力(spiky capabilities)」と呼ぶものがよく見られます。国際数学オリンピックの難問を解いたり、囲碁で非常に難しい一手を打ったりするのは得意なのに、別のことを頼むとまるでだめで、PDFのフォームすら埋められない。「なぜこんな簡単なことができないのか」と思いますよね。
これは、これまでのAIが、人間から「このデータセット、このベンチマークで、これを得意になれ。囲碁で強くなれ」と指示されて学習してきたからです。だから別のゲームをやらせると、まるで弱い。
AIをオープンエンドに進化させれば、自分のスキルが足りない「谷間」を見つけては埋めることを繰り返し、ほかのAIと協調しながら、自力でどんどん良くなっていけます。
―システムに明確なゴールはあるのですか。それとも、ゴールを設定する必要はないのでしょうか。
ゴールはあります。最も大きな視点で言えば、究極的には人類が繁栄できるようにすることです。そのうえで、より賢くなっていくこともゴールにします。「さまざまなベンチマークで高い成績を出せ」というのが単純な設定方法ですが、「さまざまなタスクを解けるようになれ」「自分の効率を最適化せよ」、つまり同じ結果を出すのに使うエネルギーやトークンを減らせ、といった設定もできます。
最終的には、人類が、そして当社の人間がゴールを設定します。そのゴールを達成するさまざまな方法を、AIが見つけていくのです。
大手も動き出した「AIによるAI研究」
AIにAIの研究開発を担わせるという発想は、リカーシブだけのものではない。取材後の数カ月で、大手AI企業からも具体的な数字が相次いで公表されている。
「AIによるAI研究」各社の現在地
各社の発表と取材内容を基に整理(2026年9月時点)
| 企業 | 公表された取り組み・成果 | 現在地と今後 |
|---|---|---|
| OpenAI2026年9月発表 | 人間の指示・監督のもと、熟練研究者が数日かける明確な研究タスクをこなす「自動化された研究インターン」の実現を発表。 | 2028年3月までに、自動化されたAI研究者の実現を目指す。 |
| Anthropic2026年5月時点の数値 | 同社のコードベースにマージされるコードの8割超をClaudeが記述。 | 完全な再帰的自己改善には「まだ至っていない」と説明。開発減速・一時停止については、他の主要企業との検証可能な協調を条件としている。 |
| Google DeepMind2025年5月発表 | コーディングエージェント「AlphaEvolve」が、Geminiの学習に使う行列計算を23%高速化。 | その改善により、Gemini全体の学習時間を1%短縮したと発表。 |
| Recursive | 進化に着想を得た、終わりを決めない探索を研究の軸に置く。 | 再帰的自己改善を中心目標に据え、まずAI研究の自動化に取り組む。 |
※各社の到達段階や数値の測定対象は異なります。成果の優劣を直接比較する表ではありません。
大手にとって、AI研究の自動化は主力モデルの開発を加速する手段の一つだ。これに対してリカーシブは、それ自体を事業の中心に置く。ソッチャー氏はこの違いを「一点集中」と表現する(後編で詳しく紹介)。
記事後編は…
人間がゴールを決め、達成の方法はAIが探す。ただし、AIが見つけた方法が人間の意図に沿うとは限らない。自分自身を書き換えていくAIを、どう人間の意図につなぎとめるのか。後編では、ソッチャー氏が「最も難しい問題」と語る報酬ハック、取材翌日に公開された最初の成果、そして日本企業に求めるパートナー像を聞く。
※取材は2026年6月10日に実施。発言内容は取材時点のもの。